
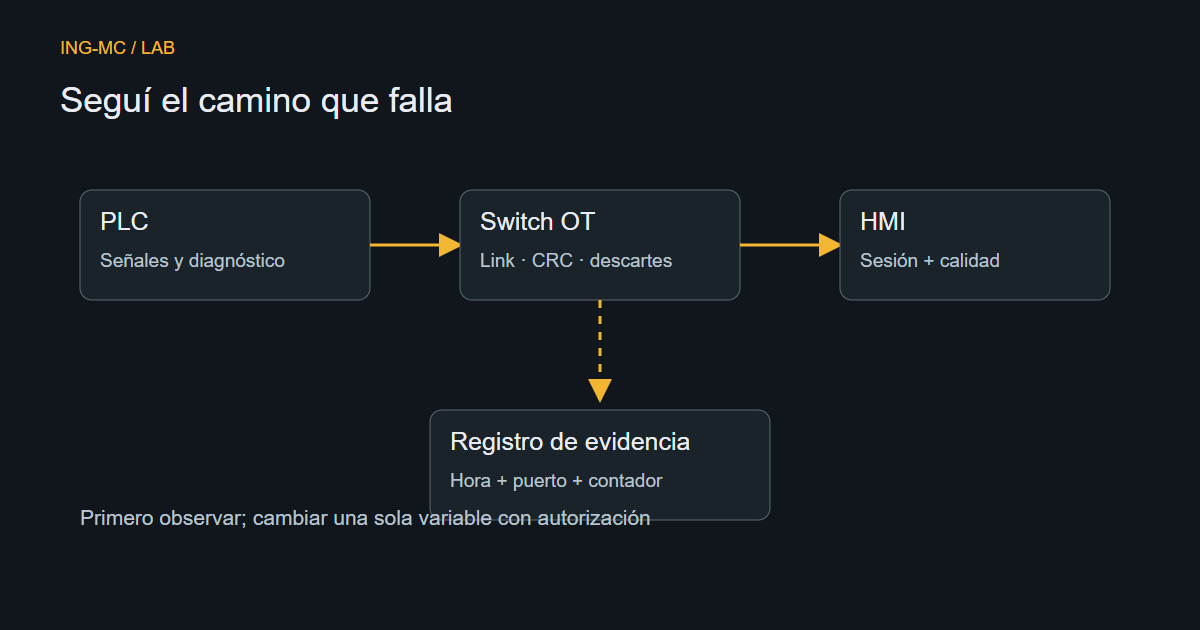
“El PLC se desconecta a veces” describe un síntoma, no una causa. ¿Cae el enlace? ¿Vence una solicitud del protocolo? ¿Solo una sesión HMI deja de actualizar? En pantalla pueden verse iguales, pero necesitan evidencia distinta.
Dibujá el recorrido real
Identificá puerto del controlador, cables, puertos de switch, límites VLAN, saltos enrutados y equipo HMI. Diferenciá un panel local de un cliente remoto. Si solo falla el remoto, la conexión común al PLC podría funcionar y el problema estar más adelante.
No asumás conectividad desde un dibujo que omite la configuración del switch o da por hecho que todas las subredes se alcanzan. Empezá por documentación aprobada e inspección de solo lectura. Cambios de red, escaneos intrusivos y capturas de tráfico en operación requieren autorización y procedimientos del sitio.
Registrá un intervalo, no solo una captura
Anotá inicio y fin de la falla, qué equipos fallan juntos y si coincide con una actividad de producción. Coincidir con el arranque de un motor es una pista, no una prueba de ruido eléctrico. Conservá logs de conexión al controlador, HMI y puertos relevantes durante el mismo intervalo.
Un contador de 100 errores puede acumular meses de historia. Registralo al inicio y al final, y compará la diferencia. Anotá también cualquier reinicio del equipo o del contador. Una captura sin intervalo no permite saber si los errores aumentaron durante el incidente.
Revisá por capas
| Observación | Próxima comprobación de solo lectura |
|---|---|
| El enlace cae y vuelve repetidamente | Logs de puerto, conectores e inspección autorizada del cable |
| Aumentan errores CRC/FCS | Camino físico, equipo extremo y negociación del enlace |
| Aumentan descartes sin errores CRC | Evidencia de colas/congestión y patrón de tráfico |
| Enlace estable, pero falla un protocolo | Dirección, ruta, servicio y diagnóstico de conexión del controlador |
| Las lecturas funcionan, pero la pantalla se congela | Calidad de bindings, logs y ciclo de vida del cliente |
La referencia de diagnóstico de interfaces de Cisco describe síntomas de CRC, descartes y enlace. Un contador apunta a una clase de problemas; no identifica por sí solo una pieza dañada. Los comandos y nombres cambian según la plataforma.
Comprobá direcciones sin adivinar
Compará IP, máscara, gateway y VLAN configurados contra el diseño aprobado. Una IP aparentemente válida no basta si la máscara ubica el destino en el lado incorrecto de un router. Verificá ambos sentidos y posibles indicios de direcciones duplicadas.
Ping ayuda cuando está permitido, pero una respuesta no valida datos Modbus ni la salud de una conexión EtherNet/IP. El bloqueo de ICMP tampoco prueba que falle la aplicación. Para Modbus, revisá la respuesta y excepciones según la guía de registros.
Cambiá una variable y conservá la línea base
Si un responsable aprueba sustituir cable o puerto, capturá el antes y después y observá durante un intervalo comparable. No cambiés a la vez cable, dúplex, polling y configuración del switch: aunque mejore, no sabrás qué cambio resolvió la causa.
No borrés contadores sin guardar evidencia. No reiniciés todo como primera medida: podrías perder los logs necesarios y generar otra interrupción.
Dejá un registro que sirva
Guardá revisión de topología, equipos afectados, puertos, intervalo, diferencias de contadores, error de aplicación, cambio aprobado y resultado de la verificación. Las direcciones privadas pertenecen al registro interno, no a un tutorial público. Un incidente reproducible aporta más que afirmar que la red está “lenta”.

